这篇论文的核心在于“利用负项,减少讨论”。
Online-to-Batch Conversion
老生常谈的东西,约等于加权Jensen不等式。
L(xˉT)−L(x⋆)=≤≤L(α1:T1t=1∑Tαtxt)−L(x⋆)α1:T1t=1∑Tαt(L(xt)−L(x⋆))α1:T1E[t=1∑Tαt⟨∇ℓt(xt),xt−x⋆⟩].
目前更多的是采用 Ashock Cutkosky, 2019 的 Stabilized Online-to-Batch Conversion 。
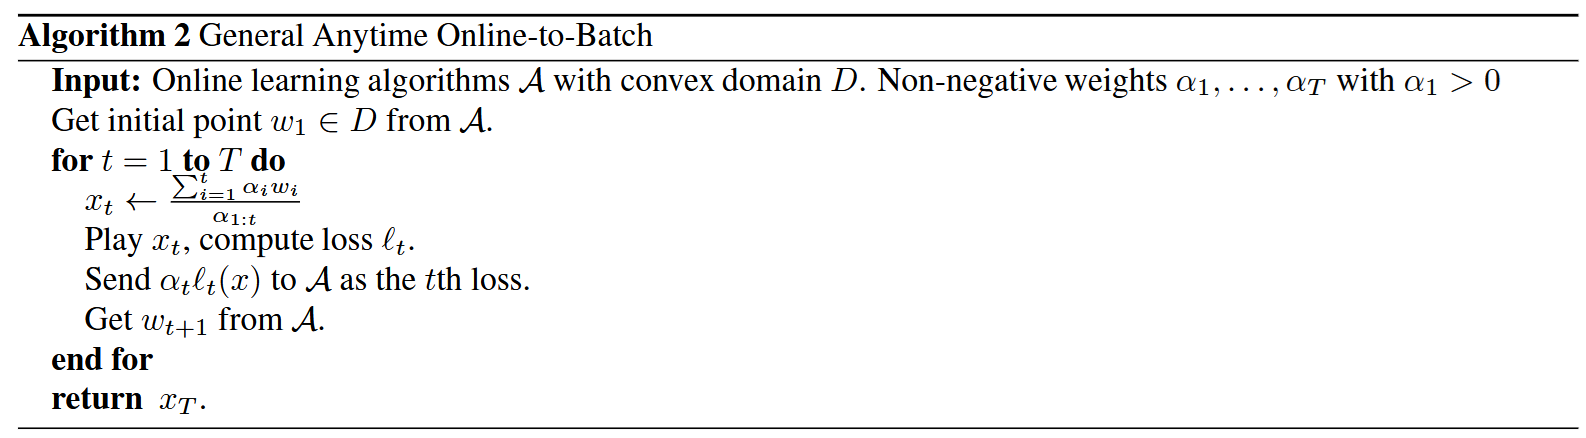
这里不采用图中的符号,记 xˉt=α1:t∑s=1tαsxs 。这种方法的核心在于发现
α1:txˉt=αt(xˉt−xt)=α1:t−1xˉt−1+αtxt,α1:t−1(xˉt−1−xˉt).
结合Jensen不等式
α1:tL(xˉt)≤αt(L(xˉt)−L(xt))≤α1:t−1L(xˉt−1)+αtL(xt),α1:t−1(L(xˉt−1)−L(xˉt)).
t=1∑Tαt(L(xˉt)−L(x⋆))==≤=L(xˉT)−L(x⋆)≤t=1∑Tαt(L(xˉt)−L(xt))+t=1∑Tαt(L(xt)−L(x⋆))t=1∑Tαt(L(xˉt)−L(xt))+E[RTα]t=1∑Tα1:t−1(L(xˉt−1)−L(xˉt))+E[RTα]t=1∑T−1αtL(xˉt)−α1:T−1L(xˉT)+E[RTα],α1:TE[RTα].
在这种情况下可以利用 L 的特殊性质。比如,如果 L 是λ-strongly convex 的,有
α1:tL(xˉt)≤αt(L(xˉt)−L(xt))≤αt(L(xˉt)−L(xt))≤α1:t−1L(xˉt−1)+αtL(xt)−2λα1:tα1:t−1αt∥xˉt−xt∥2,α1:t−1(L(xˉt−1)−L(xˉt))−2λα1:tα1:t−1αt∥xˉt−xt∥2,α1:t−1(L(xˉt−1)−L(xˉt))−2λα1:tαtα1:t−13∥xˉt−xˉt−1∥2.
因此
L(xˉT)−L(x⋆)≤α1:TE[RTα]−α1:T1t=1∑T2λα1:tαtα1:t−13∥xˉt−xˉt−1∥2.
Reduce smooth parameter with adaptive learning rate
完整流程详见 Theorem 1 及其证明。在算 RT 时会遇到
ηt=AT=RT≲=AtD,∥∇f1(x1)∥2+t=2∑T∥∇ft(xt)−∇ft−1(xt−1)∥2,DAT−t=2∑Tηt+11∥xt−xt−1∥2DAT−t=2∑TDAt∥xt−xt−1∥2.
简单假设 ft 是 L-smooth 的。那么
AT==≲≲AT≲≲≲≲∥∇f1(x1)∥2+t=2∑T∥∇ft(xt)−∇ft−1(xt−1)∥2∥∇f1(x1)∥2+t=2∑T∥∇ft(xt)−∇ft−1(xt)+∇ft−1(xt)−∇ft−1(xt−1)∥2∥∇f1(x1)∥2+t=2∑T∥∇ft(xt)−∇ft−1(xt)∥2+t=2∑T∥∇ft−1(xt)−∇ft−1(xt−1)∥2∥∇f1(x1)∥2+t=2∑T∥∇ft(xt)−∇ft−1(xt)∥2+L2t=2∑T∥xt−xt−1∥2,∥∇f1(x1)∥2+t=2∑T∥∇ft(xt)−∇ft−1(xt)∥2+L2t=2∑T∥xt−xt−1∥2∥∇f1(x1)∥2+t=2∑T∥∇ft(xt)−∇ft−1(xt)∥2+Lt=2∑T∥xt−xt−1∥2∥∇f1(x1)∥2+t=2∑T∥∇ft(xt)−∇ft−1(xt)∥2+LD+DLt=2∑T∥xt−xt−1∥2VT+LD+DLt=2∑T∥xt−xt−1∥2.
代入 RT
RT≲DVT+LD2+TODOt=2∑T(L−DAt)∥xt−xt−1∥2.
目的是使 TODO 项为负项,并使得 At 不依赖于 L 的取值。当 At≥LD 时, TODO 项显然为负,问题是 At<LD 。此时直接代入 RT 原本的表达式
RT≲≲DAT−t=2∑TDAt∥xt−xt−1∥2LD2.
比刚才推导的 bound 还要小。所以 At 不需要做约束。
Methods on Proof of Theorem 3
相对于普通的Smooth、Lipschitz情况做法有些区别。
Utilizing Bregman Divergence
t=1∑Tft(xt)−ft(x⋆)=t=1∑T⟨ft(xt),xt−x⋆⟩−t=1∑TDft(x⋆,xt).
首先 ft 得是凸函数,其次在 ft 是 λ-strongly convex 的情况下,会有一些 bonus:
Dft(x,y)≥2λ∥x−y∥2.
这一步被用到证明原文中 TERM-A 小于 TERM-B 。此外
TERM-B≲≲≲≲≲t=1∑Tλt1∥∇ft(xt)−∇ft−1(xt−1)∥2t=1∑Tλt1∥∇ft(xt)−∇ft(x⋆)+∇ft(x⋆)−∇ft−1(x⋆)+∇ft−1(x⋆)−∇ft−1(xt−1)∥2t=1∑Tλt1(∥∇ft(xt)−∇ft(x⋆)∥2+∥∇ft(x⋆)−∇ft−1(x⋆)∥2+∥∇ft−1(x⋆)−∇ft−1(xt−1)∥2)t=1∑Tλt1∥∇ft(xt)−∇ft(x⋆)∥2+t=1∑Tλt1∥∇ft(x⋆)−∇ft−1(x⋆)∥2t=1∑TλtLDft(x⋆,xt)+t=1∑Tλt1x∈Xsup∥∇ft(x)−∇ft−1(x)∥2
代入 RT 会收获
t=1∑T(λtL−21)Dft(x⋆,xt)
还有两个关于积分的不等式,用于放缩得到闭式上界,看原论文就行。
Methods on Lemma 6
Utilizing Strongly Convex Setting
见 Online-to-Batch Conversion 。和论文中方法不太一样,应该也能用?
最终结果是构造出 Lemma 6 的形式
(λ(1+βt)4Ltβt2−1)α1:t−1D(xˉt−xˉt−1)
这个玩意在 βt≤4Ltλ 时为负,可以直接舍弃。
不懂为什么 βt=βˉ 的情况不用负项消除。